Artificial Analysis Intelligence Index v5 基准上线,DeepSeek V4.1 Flash 1017 为 FrontierCode 2.0 开源模型最高成绩
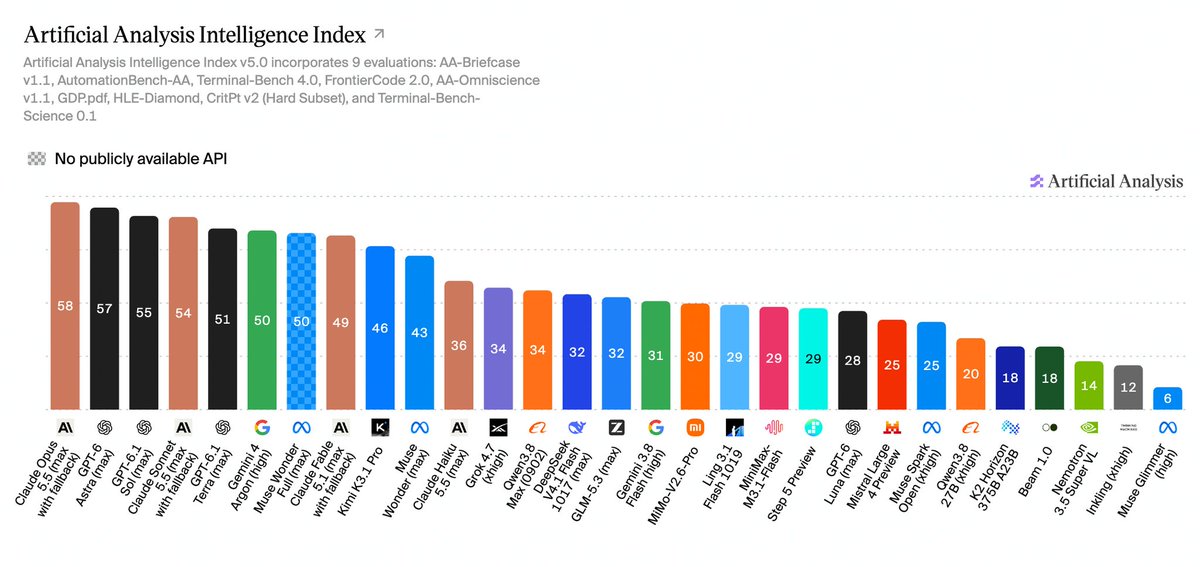
IT之家 10 月 29 日消息,Artificial Analysis 于昨日推出 Intelligence Index v5,这是该机构自 2026 年 1 月 v4 上线以来变动幅度最大的一次基准更新。
最显著的变化是,60% 的评测权重首次基于私有测试集或隐藏答案,旨在压缩公开题库被模型训练数据“污染”的空间,减少各厂商为刷分而进行的“注水”测试项目。
该指数仍由九项评测构成,包括知识工作、编码、科学、通用能力各占 25%。其中编码 25% 的权重里,Cognition 于同日发布的 FrontierCode 2.0 独占 15%,Terminal-Bench 4.0 占 10%。
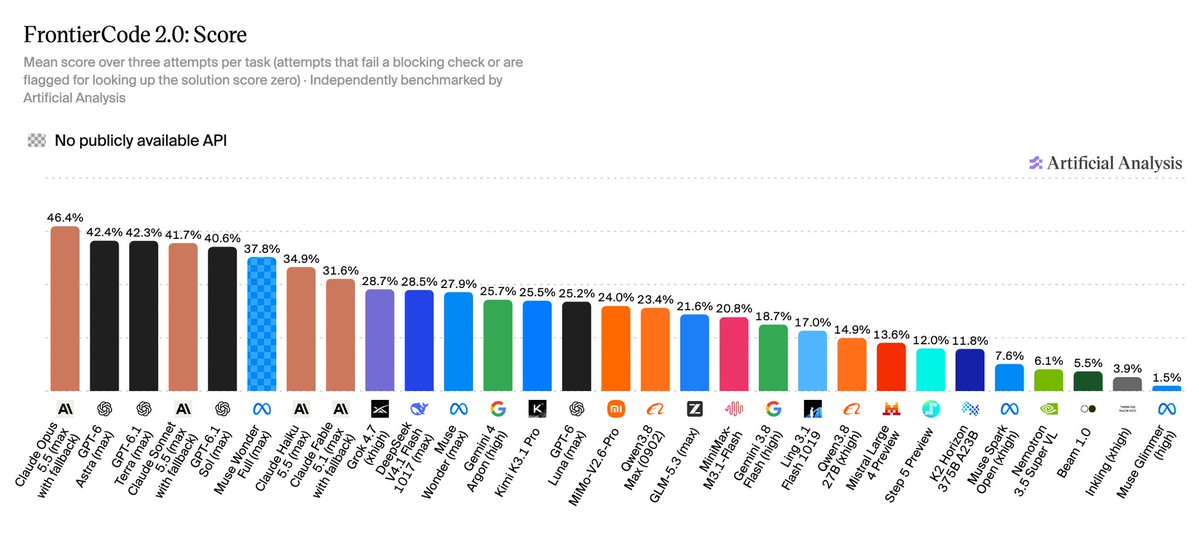
其中最值得关注的 FrontierCode 2.0 采用了全新的评分逻辑。132 项任务全部来自真实开源仓库,模型提交的代码改动不再仅依据单元测试是否通过,而是由仓库维护者按“是否愿意合并这个 PR”来打分,任何一项阻塞性检查失败即计零分。
Cognition 在 6 月推出 FrontierCode 初版时就强调,传统基准只检查代码能否运行,而合并决策还涉及改动范围是否克制、风格是否与代码库一致、回归风险是否可控等测试无法完全覆盖的维度。v5 将这一基准升级到 2.0 并纳入主指数,相当于把“可合并性”而非“可运行性”置于编码能力评价的核心。
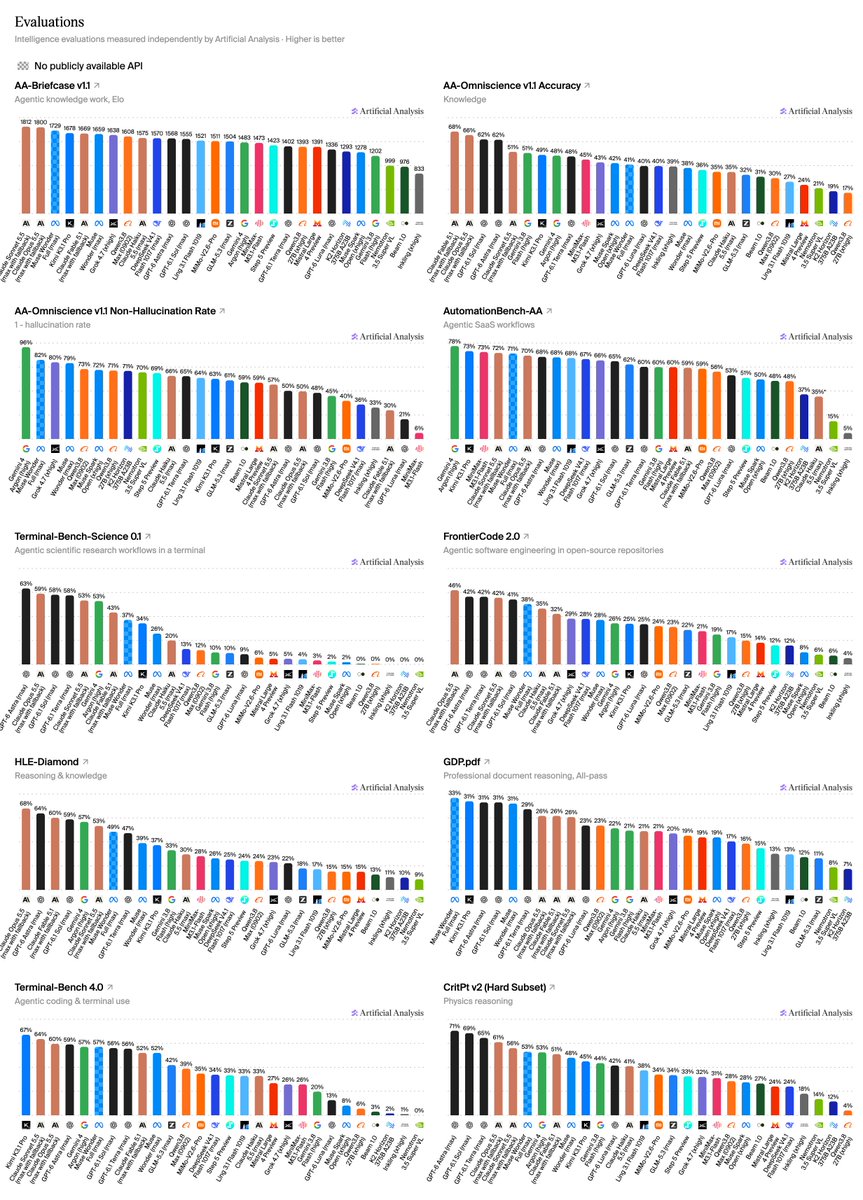
在此口径下,DeepSeek V4.1-Flash 1017(max)在 FrontierCode 2.0 上取得 28% 的成绩,在所有已发布权重模型中得分最高。
Kimi K3.1 Pro 以 25.5% 紧随其后,但其完整权重据月之暗面官方博客表述,要到 11 月 4 日前才发布,AA 在 v5 报告中将其标注为“weights not yet released”。
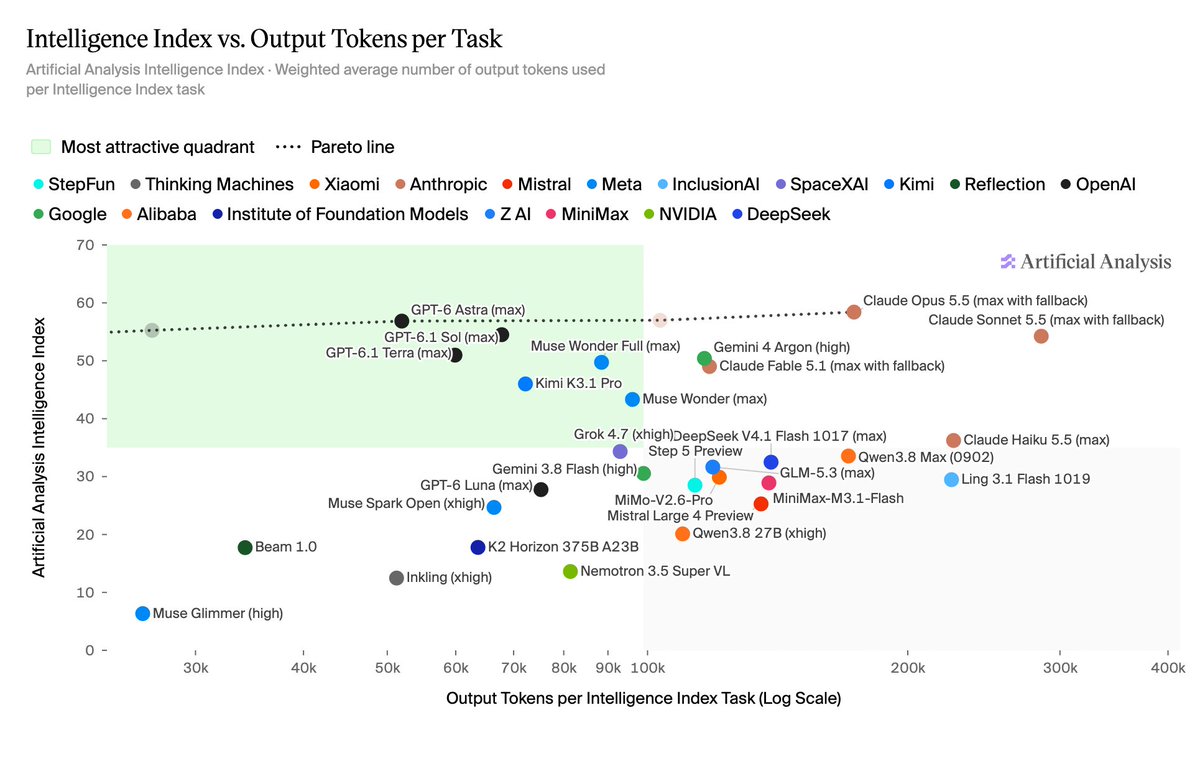
谷歌 Gemini 4 Argon(high)为 25.7%,GPT-6 Luna 为 25.2%,均低于 DeepSeek V4.1 Flash。需要说明的是,这一成绩属于 FrontierCode 2.0 单项;在 Intelligence Index v5 的综合得分上,DeepSeek V4.1 Flash 与 GLM-5.3 同为 32 分,仍落后榜首 Claude Opus 5.5(58 分)26 分,且低于 Claude Haiku 5.5 的 36 分。
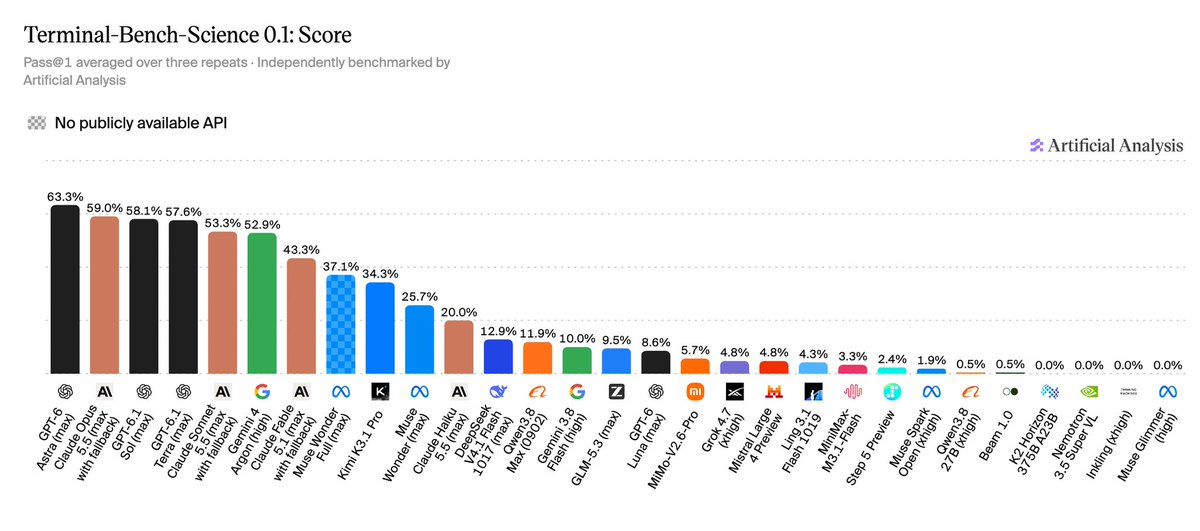
Artificial Analysis 指出,v5 真正加剧的是开源与闭源前沿之间的整体差距。在 v4.3 时,最强开源模型与榜首的差距为 3 分;v5 将大部分公开题换成私有题、并大幅加重智能体实战任务的比重后,这一差距扩大到 12 分。Kimi K3.1 Pro 以 46 分成为名义上最强的开源权重模型,但它尚未发布权重;已发布权重的模型中,32 分是当前的天花板。
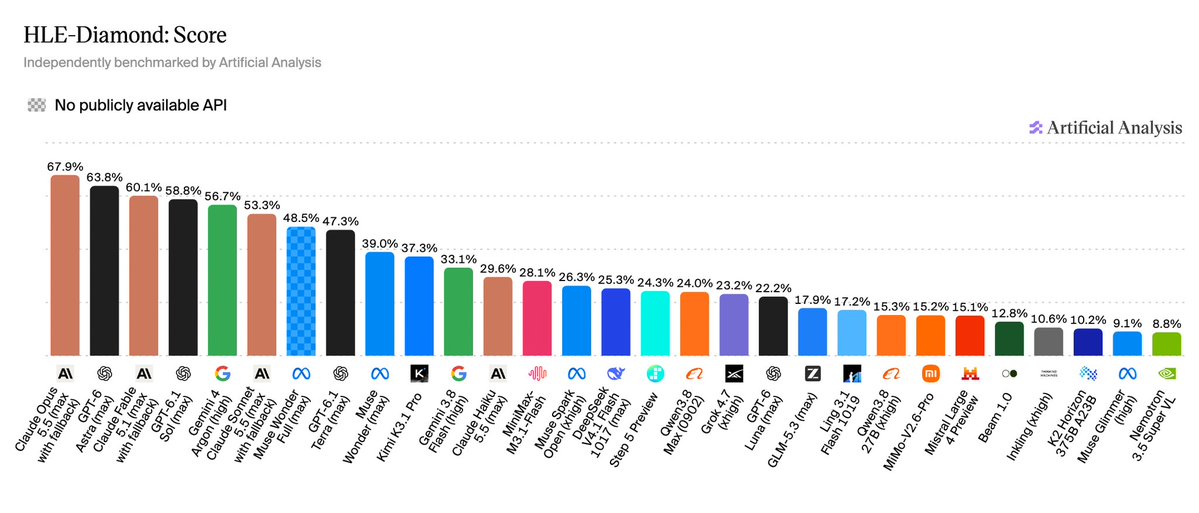
差距在 HLE-Diamond 和 Terminal-Bench-Science 两项上最为显著:Kimi K3.1 Pro 分别为 37% 和 34%,而 Claude Opus 5.5 在 HLE-Diamond 上为 68%,GPT-6 Astra 在 Terminal-Bench-Science 上为 63%。
v5 并未让开源模型“一夜变差”,它改变的是测量的对象——当题目不再公开、评分不再仅看通过率,那些依靠公开题库优化出来的分数被系统性地挤掉了水分。
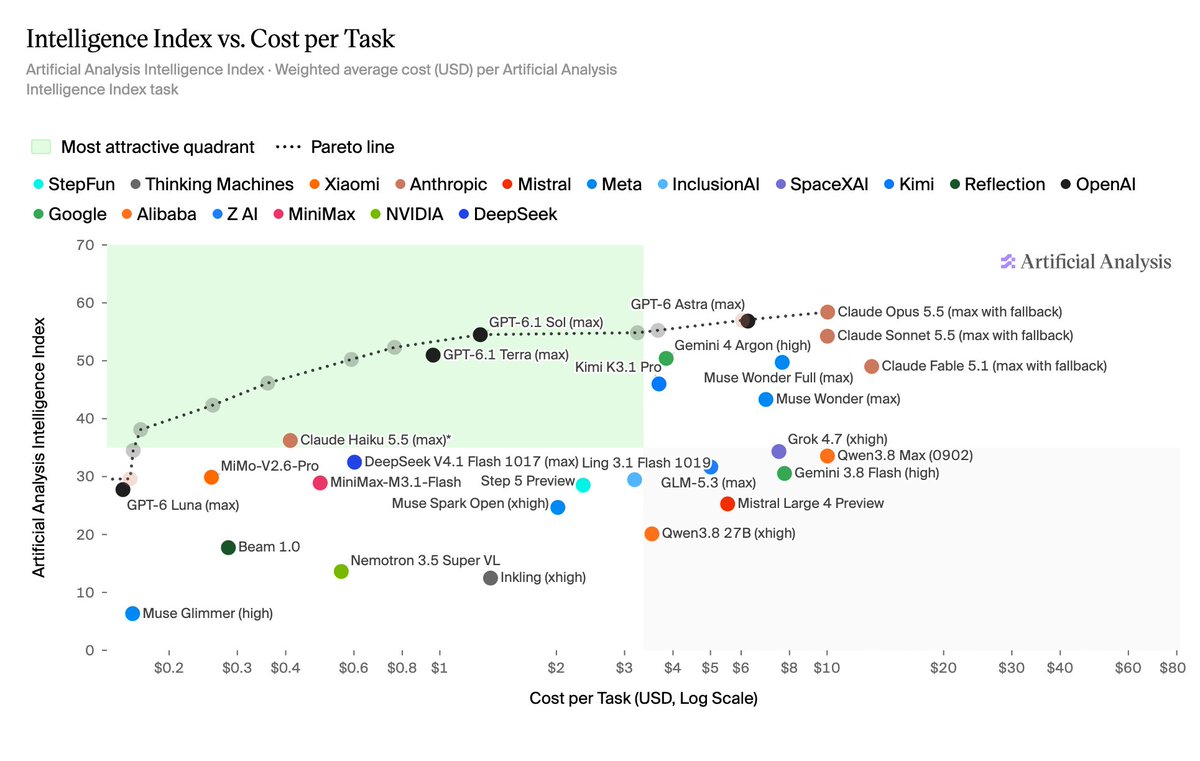
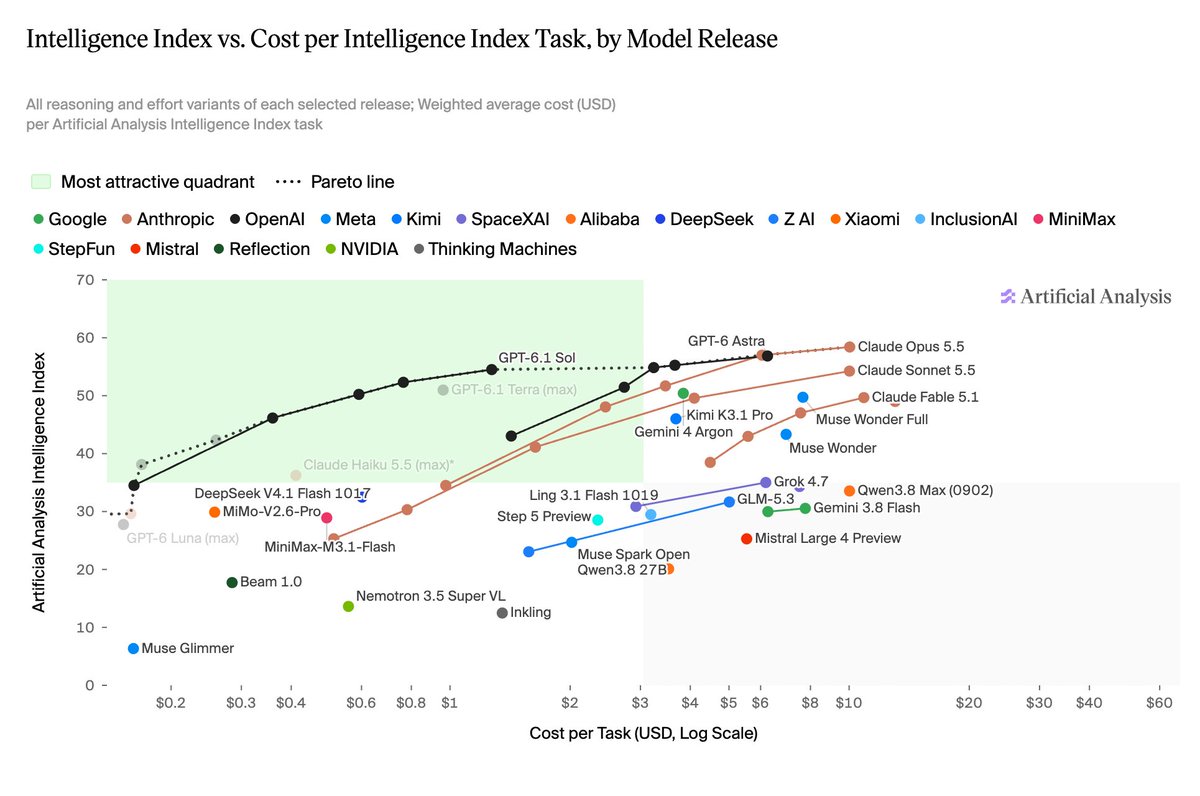
另一个被 v5 放大的变量是“努力值”(思考等级)的成本优势。Claude Opus 5.5 从低努力档到 max 档跨越 23 分,单任务成本从 0.98 美元升至 10.04 美元,相差约 10 倍。
Claude Sonnet 5.5 在不同努力档之间的分差从 v4.3 的 20 分扩大到 29 分,GPT-6.1 Sol 的跨度翻倍至 20 分。这意味着同一模型在“省钱模式”和“全力模式”下的表现差距,已经大到不像一个模型。
在得分最高的十款模型中,GPT-6.1 Terra 的每任务成本最低,为 0.96 美元,Claude Fable 5.1 最高,为 13.04 美元,相差超过 13 倍。
与 v5 同步推出的 Progress Index v1 则处理另一个问题:当基准本身每隔几个月就更换一次,不同年代的模型如何放在同一把尺子上比较。Progress Index 将 2022 年 11 月以来发布的主要语言模型映射到一个连续的能力尺度上,其设计参考了 Epoch AI 的 Epoch Capabilities Index 的方法。Intelligence Index 继续作为衡量“当下前沿”的主指标,Progress Index 则用于观察“能力随时间如何演进”,两者回答的是不同问题。
实际上,v5 的九项评测中没有任何一个模型全面领先:Claude Opus 5.5 拿下 FrontierCode 2.0、HLE-Diamond 和 AA-Omniscience 三项,GPT-6 Astra 在 Terminal-Bench-Science 和 CritPt v2 困难子集上居首,Kimi K3.1 Pro 在 Terminal-Bench 4.0 上以 67% 领先,单项优势的分散程度比总分排名更值得关注。在本次基准更新中,模型在编码任务上的表现差异尤为突出,其中 DeepSeek V4.1-Flash 1017 在 FrontierCode 2.0 上的成绩,甚至超过了部分闭源模型在类似任务中的表现,如同篮球场上的一项关键统计——NBA助攻——一样,精准地衡量了模型协作和整合代码的能力。
相关阅读:
- 《国产最强 DeepSeek V4.1 Flash-1017 登顶 Agent Arena 开源榜,总榜第 11》
- 《DeepSeek V4.1 Flash 发力,中美顶尖模型 LiveBench 跑分差距缩至 3%》


从主力角色到替补机会,每个球员的数据轨迹都反映了教练的轮换思路。长期跟踪同一球员在不同阵容中的表现,能揭示其真正的使用价值。
5条评论

篮板数据需要区分进攻篮板与防守篮板。进攻篮板更多体现球员的拼抢意识和二次进攻能力,而防守篮板则与球队整体防守策略及卡位习惯相关。两者结合才能全面评估球员的篮板贡献。
王芳
2025年3月15日 下午3时12分

得分效率不能只看场均得分。真实命中率、有效命中率、以及在不同防守强度下的得分分布,才是衡量球员得分能力的更精准指标。我们的分析会结合这些高阶数据。
张伟
2025-03-15 15:12
团队配合程度直接影响个人助攻数据。一名控卫在跑动积极、战术执行力强的体系中,助攻数往往高于在单打为主的球队。数据背后,是战术选择与球员默契的共同作用。
李明
2025年3月15日 15:12